So funktionieren Sprachmodelle
Hinter ChatGPT, Claude oder Gemini stecken große Sprachmodelle (Large Language Models, LLMs). Sie wurden mit riesigen Mengen Text trainiert und haben dabei gelernt, welche Wörter und Sätze wahrscheinlich aufeinander folgen.
Das Grundprinzip: das nächste Stück Text
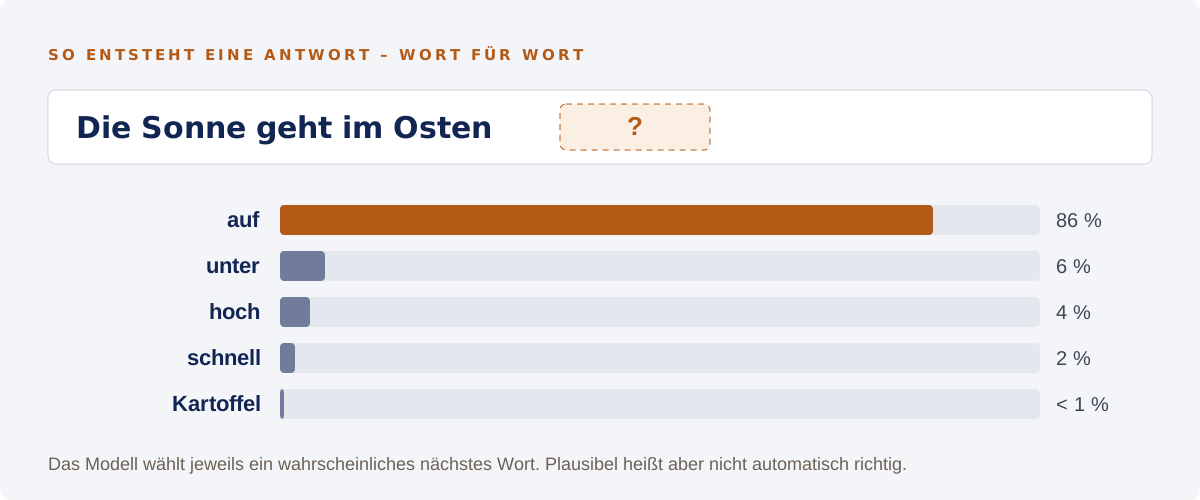
Ein LLM zerlegt Text in kleine Bausteine, sogenannte Tokens (Wortteile). Auf deine Eingabe hin berechnet es Token für Token, was am besten passt. Das klingt simpel, ergibt bei sehr großen Modellen aber erstaunlich gute Texte, Zusammenfassungen, Übersetzungen und sogar Programmcode.
Was daraus folgt
- Kein Wissen im menschlichen Sinn: Das Modell „weiß“ nichts, es erzeugt plausible Antworten. Plausibel ist nicht dasselbe wie richtig.
- Halluzinationen: Fehlen Informationen, füllt das Modell die Lücke oft mit erfundenen, aber überzeugend klingenden Details – Quellen, Zahlen, Paragrafen.
- Wissensstand: Trainingsdaten enden zu einem Stichtag. Aktuelles kennt das Modell nur, wenn es eine Websuche oder deine Dokumente nutzen darf.
- Kontextfenster: Das Modell berücksichtigt nur, was im aktuellen Gespräch steht – bei sehr langen Gesprächen gerät Früheres aus dem Blick.
- Nicht immer gleich: Dieselbe Frage kann unterschiedliche Antworten ergeben.
Vom Chatbot zum Agenten
Moderne Systeme können mehr als antworten: Sie durchsuchen das Web, lesen Dateien, nutzen Werkzeuge und erledigen mehrstufige Aufgaben – sogenannte KI-Agenten. Das spart viel Zeit, erhöht aber auch die Verantwortung: Je mehr ein System selbst tut, desto wichtiger sind klare Grenzen und deine Kontrolle.
Kommentieren ist für diesen Kurs nicht aktiviert.